Garden path evidenze e limiti
Aggiornamento del 12 ottobre 2026 · Ultimo esperimento causale GPS completato: 9 ottobre 2026
Possiamo modificare causalmente le aspettative di un modello davanti a una frase garden-path; non abbiamo ancora isolato il meccanismo con cui ne rivede l’interpretazione. Il risultato più solido riguarda la previsione immediata prima della parola disambiguante: trasferire uno stato interno dalla versione con virgola a quella senza virgola cambia sensibilmente la preferenza fra continuazioni, oltre i controlli considerati. Nel successivo esperimento su Gemma 3 12B, però, lo stesso intervento non cambia nessuna delle 48 risposte preferite alle domande finali, pur modificandone i margini di probabilità. Questa distanza fra previsione e risposta è il punto raggiunto dalla ricerca. L’ultimo tentativo di rafforzare il collegamento, la V4 originale, si arresta perché il modello non supera la verifica comportamentale necessaria a interpretare le patch. Il report distingue ciò che questi risultati dimostrano, le spiegazioni ancora compatibili e l’esperimento che servirebbe per studiare davvero la reinterpretazione. (Dati e provenienza)
Il percorso si può leggere a tre profondità. Il primo livello introduce le frasi e il risultato senza prerequisiti. Il secondo ricostruisce le decisioni sperimentali e interpreta i grafici. Il terzo definisce le misure, i controlli e i limiti di riproducibilità. I successivi esperimenti sull’attribuzione generale dei ruoli costituiscono un filone distinto e non sono inclusi come risultati sui garden-path.
Livello 1 — Spostare un’aspettativa non dimostra una reinterpretazione
Una frase può cambiare struttura mentre la leggiamo
Consideriamo questa frase inglese, mostrandola prima incompleta:
While the guard watched the poet …
Una lettura plausibile è «Mentre la guardia osservava il poeta…». Il verbo watched può avere un oggetto e the poet può ricoprire quella funzione. Non abbiamo ancora incontrato nulla che obblighi ad abbandonare questa lettura. Ora aggiungiamo il seguito:
While the guard watched the poet was greeted by the chef.
La struttura finale è diversa: «Mentre la guardia osservava, il poeta fu salutato dallo chef». The poet è il soggetto della principale was greeted by the chef, non l’oggetto sintattico di watched. Il passaggio che forza questa riorganizzazione comincia con was. La guardia osservava; il testo non specifica necessariamente che cosa. Lo chef salutava; il poeta riceveva il saluto. Sono due eventi, e attribuire correttamente i partecipanti al secondo non risponde automaticamente a tutte le domande sul primo.
Una virgola anticipa il confine:
While the guard watched, the poet was greeted by the chef.
Il contenuto finale inteso rimane lo stesso, ma l’indizio arriva prima. La virgola segnala che the poet inaugura una nuova proposizione e riduce l’attrattiva dell’aggancio al verbo precedente. Questo è il tipo di confronto al centro degli ultimi esperimenti GPS: non chiedere soltanto se due frasi ricevono probabilità diverse, ma verificare se l’informazione introdotta da quell’indizio può essere trasferita intervenendo negli stati interni. L’esempio illustra il formato sintetico del ponte 12B; non è una nuova misurazione della difficoltà di lettura umana. (Protocollo del ponte)
L’ambiguità temporanea non è un errore grammaticale finale
Un garden-path nasce dalla sequenza con cui diventa disponibile l’informazione. La frase completa può avere una lettura grammaticalmente ben definita, mentre un suo prefisso invita a costruirne un’altra. La difficoltà non consiste necessariamente nel conoscere il significato di ogni parola. Consiste nel riassegnare una funzione a parole già incontrate quando il seguito non si inserisce nella struttura inizialmente favorita.
Un altro esempio è «The old man the boat». All’inizio the old man suggerisce «il vecchio». Per leggere l’intera frase, però, occorre interpretare the old come «gli anziani» e man come verbo: gli anziani presidiano o governano la barca. La forma di una parola può sostenere due funzioni, e il seguito cambia quale delle due è compatibile con la frase. Nel progetto questo tipo di ambiguità nome/verbo appartiene soprattutto all’esplorazione iniziale; gli esperimenti successivi si concentrano sull’aggancio di un gruppo nominale fra subordinata e principale.
Anche il titolo «The diffusion of language models human migrations» gioca con questa possibilità. Language models invita a leggere «modelli linguistici»; il seguito richiede invece models come verbo, ottenendo «La diffusione del linguaggio modella le migrazioni umane». È un’illustrazione della ristrutturazione sintattica, non un’affermazione scientifica sulle migrazioni e non uno stimolo da cui derivano i risultati numerici qui presentati.
La cautela decisiva riguarda il modello. Dire che una persona «ha inizialmente letto la frase in un certo modo» descrive un’ipotesi sulla sua elaborazione. Dire che il modello preferisce una continuazione misura una distribuzione di probabilità. Il secondo dato è pertinente al primo problema, ma non consente da solo di osservare una singola interpretazione interna. Il modello potrebbe mantenere informazioni compatibili con più letture e assegnare loro pesi differenti.
Tre osservazioni che sembrano simili, ma rispondono a domande diverse
Prima di was, possiamo chiedere quanto il modello preferisca was rispetto a una virgola. Dopo the poet, was è compatibile con l’inizio del predicato principale. Una virgola può invece chiudere una subordinata nella quale il poeta è stato trattato come oggetto. Questo confronto cattura un’aspettativa locale. Non rappresenta tutte le continuazioni grammaticalmente possibili, e non equivale a contare quante volte il modello «ha capito» la frase.
Dopo l’intera frase possiamo chiedere «Who greeted someone?» oppure «Who was greeted?». Nella frase precedente le risposte sono, rispettivamente, chef e poet. Qui osserviamo una preferenza fra risposte complete riferite all’evento greeted. Il modello dispone ormai di was greeted by the chef: informazione che non aveva quando prevedeva il primo was.
Infine possiamo domandarci se una manipolazione interna cambi quale risposta vince. La probabilità relativa può spostarsi senza attraversare la soglia. Come esempio puramente didattico, se la risposta corretta passa da un vantaggio di 2 a un vantaggio di 1,5, l’intervento ha un effetto, ma la risposta preferita resta quella corretta. Questi numeri non sono risultati sperimentali; servono a distinguere una misura continua da una scelta binaria.
Aspettativa sul seguito, margine della risposta e risposta favorita sono quindi tre esiti distinti. Per dimostrare una reinterpretazione vorremmo collegarli a una transizione specifica: una conseguenza della lettura iniziale deve essere riveduta dopo l’informazione disambiguante. La sola previsione locale non completa quel collegamento. Nemmeno una risposta finale corretta lo completa, se può essere ottenuta usando soltanto la principale.
Che cosa significa modificare uno stato interno
Durante l’elaborazione, il modello costruisce per ogni posizione una successione di vettori numerici. Questi stati contribuiscono ai calcoli successivi. L’intervento impiegato qui prende lo stato di una posizione nella frase donatrice e lo sostituisce allo stato corrispondente nella frase destinataria. Il testo visibile della destinataria resta quello previsto dal protocollo; cambia un elemento del calcolo interno.
Nell’esempio, possiamo prelevare lo stato associato alla fine di the poet dalla versione con virgola e inserirlo nella versione senza virgola. Il sito precede was: interveniamo sull’informazione disponibile quando il modello deve prevedere quella parola. Se la previsione cambia, abbiamo una prova causale rispetto a quella sostituzione. Non stiamo soltanto osservando due numeri che variano insieme.
Lo stato trasferito, però, è un vettore completo. Può portare informazione sulla punteggiatura, sul verbo, sulla posizione, sui partecipanti e sulle loro relazioni. L’intervento non reca un’etichetta che dica quale di queste informazioni sia responsabile. Per questo servono confronti: reinserire lo stesso stato, alterare il lessico, perturbare nella stessa misura lungo direzioni casuali, controllare le posizioni. Superare tali confronti restringe le spiegazioni; non rende automaticamente il vettore una variabile pura chiamata «sintassi».
Il risultato positivo riguarda la previsione prima della disambiguazione
Il risultato predittivo più controllato della V3 usa Gemma 3 1B e confronta l’effetto della virgola con verbi che ammettono un oggetto e con verbi usati intransitivamente. Su sei famiglie di test, l’intervento cambia il contrasto predittivo di 6,599 nats, con intervallo descrittivo del 95% fra 4,065 e 8,734. Il valore supera i controlli lessicale e casuale impiegati, anche dopo aver allineato gli identificatori di posizione dei token comuni. (Dati V3, report dell’esperimento 1B)
Un nat è un’unità di log-probabilità, non una percentuale di risposte corrette. Per il primo livello basta trattenere la relazione: il trasferimento dell’informazione contestuale produce uno spostamento maggiore di quello delle perturbazioni di riferimento. La quantità precisa sarà definita più avanti. È un risultato positivo, ottenuto su famiglie non impiegate per scegliere nuovamente il blocco del modello in quella versione.
La conclusione sostenibile è che alcuni stati intermedi contribuiscono causalmente alle aspettative sulle continuazioni di questi prefissi. Sarebbe più forte, e non giustificato, dire che abbiamo osservato il modello scegliere un parse errato e poi correggerlo. L’intervento avviene prima della parola che rende necessaria la nuova lettura; misura soprattutto ciò che il modello si prepara a incontrare.
Il ponte 12B separa previsione e risposta finale
Il passo successivo conserva il contesto garden-path e affianca alla previsione le domande sulla frase completa. Su Gemma 3 12B la patch produce uno spostamento predittivo di 8,069 nats, mentre il margine medio della risposta corretta cambia di −0,074 nats. Nessuna delle 48 patch cross-condition di test cambia la candidata favorita. Le 48 misure derivano da sei famiglie e non sono 48 repliche linguistiche indipendenti. (Dati del ponte, report dell’esperimento 12B)
Non significa che «la comprensione non cambia» in ogni senso possibile. I margini delle risposte cambiano, e la loro media nasconde effetti di segno opposto nelle due domande. Significa che l’intervento efficace sulla previsione non ha trasferito una diversa risposta finale nel compito usato. Le due misure non sono intercambiabili.
C’è un limite ancora più preciso. Chiedere chi saluta il poeta verifica l’evento nella principale, ma non verifica direttamente se il poeta fosse stato prima agganciato a watched e se quell’aggancio sia stato abbandonato. Il modello può ricavare la risposta da was greeted by the chef. Questa domanda finale è un primo ponte verso il significato della frase, non una lettura completa del processo garden-path.
Dove si ferma il risultato e dove comincia la prossima domanda
La V4 originale tenta di rendere quel ponte più informativo, ma il controllo iniziale fallisce su una costruzione complessa sia con 12B sia con 27B. Il protocollo si ferma prima delle nuove patch e del test di conferma. È un fallimento dello strumento comportamentale richiesto per quel disegno, non la dimostrazione che il modello non possieda rappresentazioni sintattiche. (Protocollo V4, dati del controllo)
Il prossimo esperimento GPS dovrebbe seguire la stessa ambiguità prima e dopo il disambiguatore e misurare una conseguenza dell’aggancio iniziale. La versione con virgola fornisce il riferimento non ambiguo. Gli interventi dovrebbero riguardare anche posizioni che hanno già letto la nuova evidenza, perché uno stato precedente non può aggiornarsi retroattivamente. Il risultato cercato è un cambiamento selettivo dell’interpretazione verificabile su materiali nuovi, non soltanto una maggiore probabilità di was.
Livello 2 — I controlli hanno reso più preciso il risultato e più stretta la conclusione
V1 apre la domanda, ma un picco non localizza una decisione
La prima fase esplora diverse costruzioni e diversi modelli, misurando sorpresa delle continuazioni, ablazioni e trasferimenti di stati. I materiali storici comprendono cinquanta coppie distribuite fra cinque costruzioni, più dieci esempi aggiuntivi di ambiguità nome/verbo. Le etichette originarie «canonical» e «novel» descrivono la provenienza interna delle liste: non certificano che le frasi siano naturali, che provochino un garden-path negli esseri umani o che non siano presenti nei dati di addestramento. La successiva verifica dei log è un audit, non una nuova esecuzione dei modelli. (Evidenza storica e provenienza)
Il dato più facile da raccontare era il picco delle curve di patching. Copiando l’intero residuo sulla parola ambigua, il recupero massimo del divario medio raggiunge 57,6% al blocco 2 nel modello 1B, 50,5% al blocco 2 nel 4B, 45,2% al blocco 24 nel 12B e 58,6% al blocco 28 nel 27B. I blocchi sono numerati da zero. Ogni curva riassume venti coppie nome/verbo, ma i log non conservano tutti gli effetti per singola frase e blocco necessari per ricostruire l’incertezza di quei massimi. (Dati delle curve storiche)
La tentazione era attribuire questi picchi al momento in cui il modello decide la struttura: presto nei piccoli, più tardi nei grandi. La rianalisi non sostiene una narrazione così netta. Il modello 1B raggiunge anche 44,1% al blocco 7 e il 4B 45,9% al blocco 17. Un intervento resta efficace in altre regioni. Inoltre il massimo dipende dal sito scelto, dal readout e dalla propagazione successiva dell’informazione, non soltanto da dove una rappresentazione viene costruita.
La V1 conserva quindi un valore esplorativo: indica fenomeni da controllare meglio. Le percentuali non diventano false perché l’interpretazione iniziale era troppo ambiziosa. Cambia ciò che possiamo farne. Una curva di recupero non è una registrazione del tempo della comprensione, e confrontare massimi fra architetture non isola l’effetto del numero di parametri.
V2 introduce un contrasto che distingue parte dell’ambiguità dalla punteggiatura
La V2 si concentra su una costruzione più circoscritta. Consideriamo «While the artist painted the colorful canvas…». Painted ammette l’oggetto the colorful canvas, ma quel gruppo nominale può anche iniziare una principale. Inserire la virgola dopo painted rende più esplicito il secondo caso. Un controllo sostituisce il verbo con un verbo usato intransitivamente, come sneezed: l’aggancio del quadro come oggetto diventa meno plausibile già prima della virgola.
Il disegno incrocia quindi due fattori: classe del verbo e presenza dell’indizio. Non basta osservare che una virgola cambia il seguito. Si chiede se cambi il seguito in modo diverso quando esiste la specifica ambiguità di aggancio. Questa differenza fra differenze elimina una spiegazione nella quale la virgola produce esattamente lo stesso effetto in entrambi i contesti. Non elimina ogni interazione lessicale con la punteggiatura. (Protocollo V2)
Le dodici famiglie manuali sono divise in sei di sviluppo e sei di test. Il blocco 17 del modello 1B viene scelto sui dati di sviluppo e poi mantenuto per il test. L’intervento sostituisce lo stato alla fine del nome nelle due direzioni, con e senza virgola. Sul test, l’interazione predittiva di base vale 4,698 nats; l’interazione dell’intervento vale 6,671, con intervallo [5,297; 8,305]. Il controllo lessicale vale 0,356 e quello casuale 0,488; l’identità dà zero. (Dati V2)
L’intervento resta interessante dopo questi controlli. Tuttavia la misura principale confronta due stringhe complete: «was beside the table.» e «beside the table, the assistant waited.». La prima contiene cinque token nel test, la seconda otto. Sommare le probabilità logaritmiche di sequenze diverse è una misura ben definita, ma non costituisce un confronto neutro fra interpretazioni astratte. Le stringhe differiscono anche per lunghezza e materiale lessicale.
Una verifica di robustezza cambia il significato del punteggio
Nei ventiquattro contrasti di test V2, la somma delle log-probabilità favorisce la continuazione principale in tutti i casi. La media per token la favorisce in quattordici. Nei sei casi opzionali senza virgola, la normalizzazione per token ribalta la preferenza della misura completa. Non significa che una normalizzazione abbia scoperto il «vero parse»: le due procedure rispondono a domande quantitative differenti. Significa che non possiamo usare indifferentemente quel punteggio come se fosse una probabilità della struttura. (Robustezza V2)
La scomposizione della patch mostra inoltre che circa il 90,9% dell’effetto medio deriva dal contributo della continuazione principale. Il risultato non autorizza a localizzarlo specificamente su was, perché quelle patch salvano lo score complessivo della stringa, non il contributo di ogni suo token. La V3 nasce anche da questo limite: definire una misura primaria più locale e conservare separatamente la traiettoria della continuazione.
La scelta del blocco appare meno precisa nel ricampionamento delle famiglie di sviluppo. Il 17 vince nel 25,64% dei campioni; anche 18, 24 e 16 vincono frequentemente. I blocchi dal 15 al 24 si trovano entro il 95% del massimo medio. È una fascia sensibile, descritta a posteriori, non un singolo luogo della sintassi. Il blocco testato resta comunque il 17 originariamente fissato: la rianalisi non viene usata per riscegliere sul test un punto più favorevole. (Dati di stabilità)
V3 distingue la virgola dal cambiamento degli indici di posizione
V3 usa ventiquattro adattamenti di materiali pubblicati, raggruppati in dodici famiglie del verbo opzionale: sei sviluppo e sei test, con due materiali per famiglia. Il modello rimane Gemma 3 1B pretrained e il blocco rimane 17, fissato dal percorso precedente. Non viene eseguita una nuova ricerca del massimo su questo insieme. La provenienza degli originali è documentata; le frasi adattate non hanno ricevuto una nuova validazione umana. (Protocollo V3)
La misura primaria diventa log P(was) − log P(virgola), con entrambe le alternative verificate come singoli token. Un valore positivo favorisce was, uno negativo la virgola. Le continuazioni reali vengono misurate a parte: non si finge che ogni frase debba effettivamente continuare con was per usare il contrasto diagnostico.
Inserire una virgola aggiunge anche una posizione nella sequenza. Per distinguere parte di questo effetto dal contenuto della virgola, il protocollo introduce tre condizioni. Native è il prefisso originale senza virgola. Comma contiene la virgola. Gap ha gli stessi token di native, ma gli indici posizionali dal secondo gruppo nominale vengono spostati di uno, così da corrispondere a quelli di comma una volta rimossa la virgola.
Non compare un token invisibile nella condizione gap. Si modifica un’informazione numerica con cui il modello rappresenta la posizione. Questo controllo artificiale non riproduce l’attenzione verso una virgola reale, ma permette di chiedere se quel preciso offset spieghi l’intervento. La risposta, per la misura testata, è negativa: il contrasto virgola/gap resta ampio, mentre il contrasto gap/native non presenta un effetto cross comparabile.
Il risultato V3 resiste ai controlli definiti dal protocollo
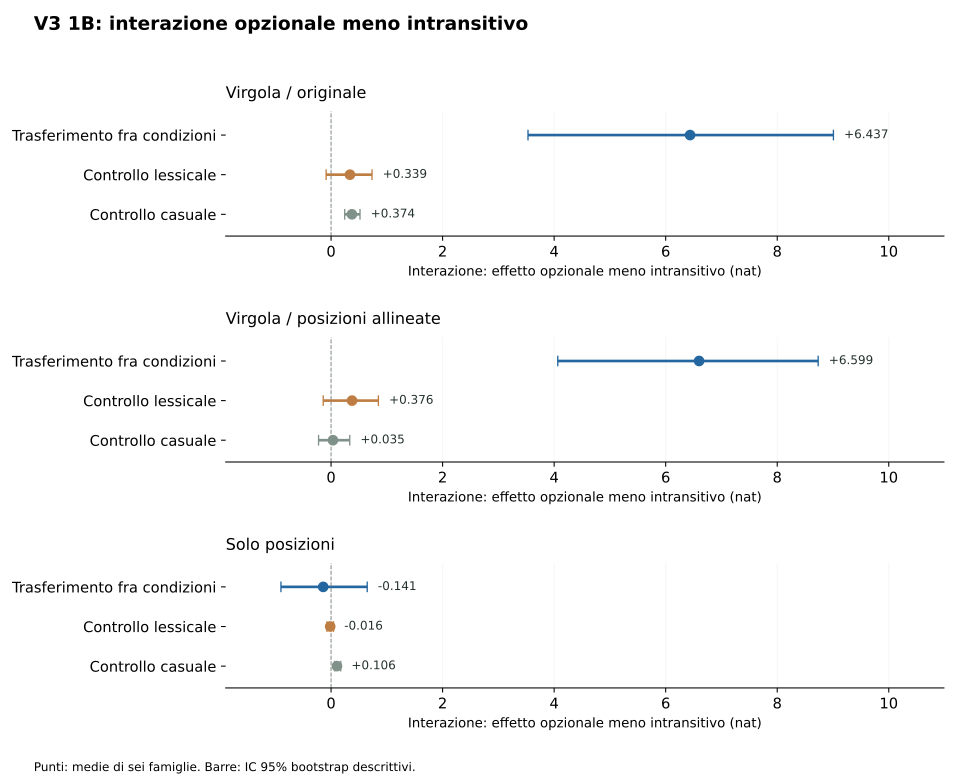
Nel confronto allineato, l’interazione opzionale meno intransitivo è 6,599 [4,065; 8,734] nats. Il controllo lessicale produce 0,376 [−0,141; 0,849], quello casuale 0,035 [−0,224; 0,335]. I vantaggi appaiati della patch sono 6,223 rispetto al lessicale e 6,564 rispetto al casuale. Tutte le sei famiglie di test hanno un effetto cross medio positivo. (Valori e intervalli della figura)
La barra gap/native è utile quanto quella principale. Il suo effetto cross vale −0,141, con intervallo [−0,898; 0,648]. Non dimostra equivalenza universale fra codifiche posizionali, ma impedisce di attribuire l’intero risultato al semplice incremento degli indici qui controllato. Il confronto virgola/native, privo dell’allineamento, produce 6,437 [3,531; 9,008], coerente con la presenza di un effetto anche nella configurazione ordinaria.
Le baseline aiutano a capire il contrasto. Con il verbo opzionale, il margine medio passa da −5,729 in native e −4,958 in gap a +3,229 con virgola. Con il controllo intransitivo è già positivo senza virgola: +1,161 in native e +2,172 in gap, contro +3,641 con virgola. La virgola cambia dunque un contesto nel quale la preferenza locale è inizialmente diversa, non soltanto un dettaglio tipografico aggiunto a prefissi indistinguibili. (Baseline complete)
Questo è il sostegno più diretto alla formulazione «sensibilità causale alle aspettative associate all’ambiguità». Non è ancora un’osservazione della struttura interna. La sottrazione intransitiva rende il risultato più specifico, ma resta possibile che lo stato trasferisca una combinazione di caratteristiche predittive del prefisso anziché una singola rappresentazione simbolica del parse.
La continuazione effettiva mostra dove si concentra l’effetto misurato
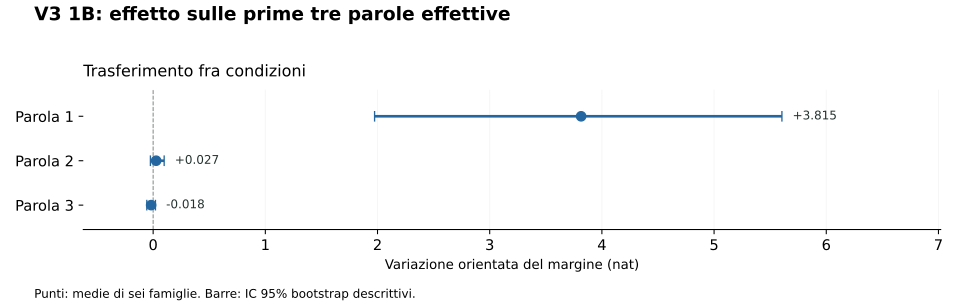
La traiettoria secondaria segue le prime tre parole effettive del seguito, che non coincidono necessariamente con il token diagnostico was. Nel contrasto allineato l’effetto sulla prima parola vale 3,815 [1,974; 5,605] nats. Sulla seconda è 0,027 [−0,024; 0,098]; sulla terza −0,018 [−0,057; 0,021]. L’effetto osservato è quindi concentrato soprattutto all’inizio della continuazione. (Dati della traiettoria)
Il seguito viene fornito al modello durante la valutazione. Quando si misura la seconda parola, la prima è già presente nel contesto; quando si misura la terza, sono presenti le prime due. Questa procedura, chiamata teacher forcing, separa il punteggio delle parole da un’eventuale generazione libera che potrebbe deviare verso un altro testo. Consente un confronto controllato, ma condiziona ogni passo alle informazioni appena fornite.
Perciò il rapido calo dell’effetto non dimostra che il modello abbia completato una riparazione sintattica alla seconda parola. Potrebbe riflettere il fatto che l’evidenza nuova rende la previsione successiva meno dipendente dallo stato sostituito. Il grafico localizza la variazione nell’uscita misurata; non identifica da solo il calcolo interno che la produce né esclude ogni conseguenza più lontana.
Il ponte 12B richiede prima uno strumento comportamentale affidabile
Per andare oltre la previsione serve un esito sulla frase completa. Il progetto introduce domande dirette sui partecipanti all’evento, ma prima verifica che il modello sappia rispondervi in condizioni semplici. In questa fase 1B e 4B non superano tutte le celle richieste; 12B supera i controlli su attive e passive semplici. Il criterio richiede entrambe le inversioni dei partecipanti corrette in almeno cinque famiglie su sei per ciascuna cella. (Qualificazione del modello)
Un esempio rende importante l’inversione. Non basta rispondere correttamente a «the poet was greeted by the chef» se la stessa strategia sbaglia «the chef was greeted by the poet». Verificare entrambe riduce il vantaggio di preferire sempre lo stesso nome. Non elimina tutte le scorciatoie, ma rende il successo di una famiglia più esigente di una singola risposta fortunata.
Il ponte impone anche un secondo controllo nel contesto con virgola. Il 12B ottiene cinque famiglie su sei nella domanda agente con virgola e sei su sei nelle altre tre combinazioni di contesto semplice/con virgola e ruolo. Il test causale può quindi partire. Il blocco 32 è fissato attraverso una regola di profondità relativa a partire dal blocco 17 del modello 1B: non viene scelto cercando il miglior effetto sul 12B e non è dichiarato un blocco funzionalmente omologo. (Protocollo del ponte)
Lo stesso intervento produce tre letture diverse del risultato
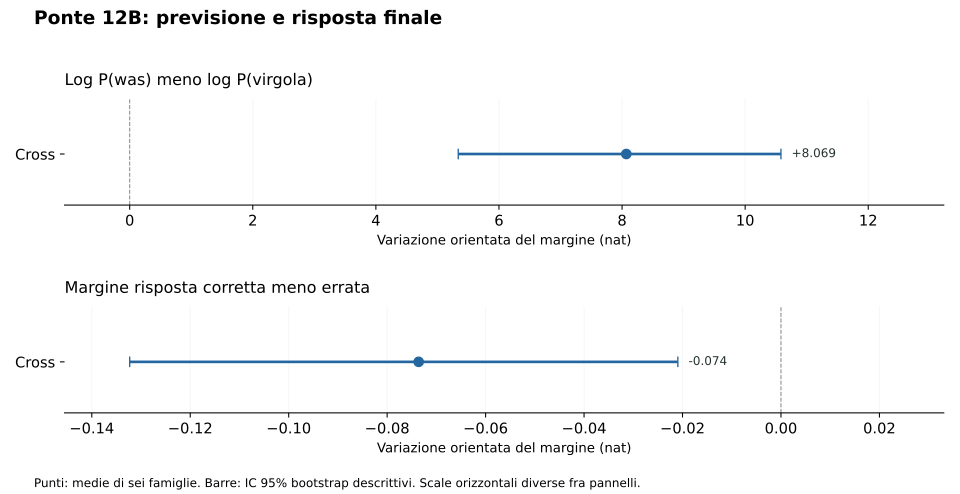
Il ponte usa dodici famiglie sintetiche, sei sviluppo e sei test, due ordini dei partecipanti e due domande. La principale è passiva. La patch precede was e le stesse esecuzioni permettono di misurare sia la previsione in quel punto sia il punteggio delle risposte dopo la frase. Il risultato primario cross è 8,069 [5,338; 10,582] nats sulla previsione e −0,074 [−0,132; −0,021] sul margine QA corretto meno errato. (Dati del ponte)
Le due quantità condividono l’unità, ma non sono scale intercambiabili della comprensione. La prima riguarda il rapporto fra due token dopo un prefisso; la seconda il rapporto fra due risposte dopo un testo più lungo. Anche il loro segno viene orientato rispetto alla direzione del trasferimento. Non bisogna leggere il valore negativo medio QA come se ogni singola patch peggiorasse ogni risposta.
Il dato discreto è più semplice: zero scelte cambiate su 48 patch cross di test. Questo non cancella l’effetto continuo, il cui intervallo medio non comprende zero. Distingue ciò che si sposta da ciò che resta stabile. Una conclusione di «assenza di effetto sulle risposte» sarebbe falsa; una conclusione di «trasferimento dell’interpretazione finale» non sarebbe sostenuta.
I controlli sostengono l’effetto predittivo, non uno scambio di interpretazione
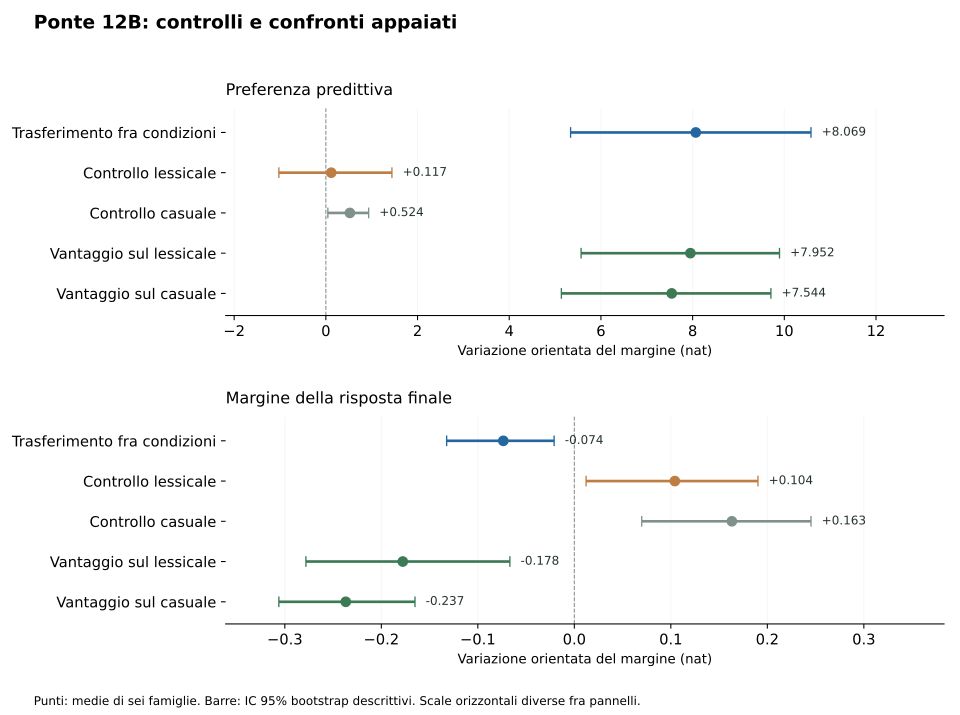
Sul contrasto predittivo, il controllo lessicale produce 0,117 nats e quello casuale 0,524. Il vantaggio cross appaiato è 7,952 [5,567; 9,895] rispetto al lessicale e 7,544 [5,137; 9,708] rispetto al casuale. Sulla QA i controlli danno invece medie positive, 0,104 e 0,163, mentre il cross medio è negativo. Le differenze cross meno controllo valgono rispettivamente −0,178 e −0,237. (Effetti e confronti appaiati)
Il grafico mostra quindi una dissociazione rispetto a controlli espliciti. La grande influenza sulla previsione non è riprodotta dalle perturbazioni di riferimento; la QA ha un profilo diverso. Non si tratta di provare che la previsione sia «vera sintassi» e la QA un dettaglio irrilevante. Si tratta di osservare che un intervento efficace per una misura non stabilisce automaticamente il meccanismo dell’altra.
Le baseline rendono la distanza ancora più concreta. Nel test, gap favorisce la virgola rispetto a was, con margine medio −4,298, ma dopo la frase completa le domande sono corrette in dodici casi su dodici per ciascun ruolo. Aspettarsi localmente una continuazione diversa è compatibile con rispondere correttamente quando viene fornito il seguito. Questa compatibilità non certifica come sia avvenuto l’aggiornamento: la domanda finale non misura direttamente l’aggancio a watched.
La media QA nasconde due effetti opposti
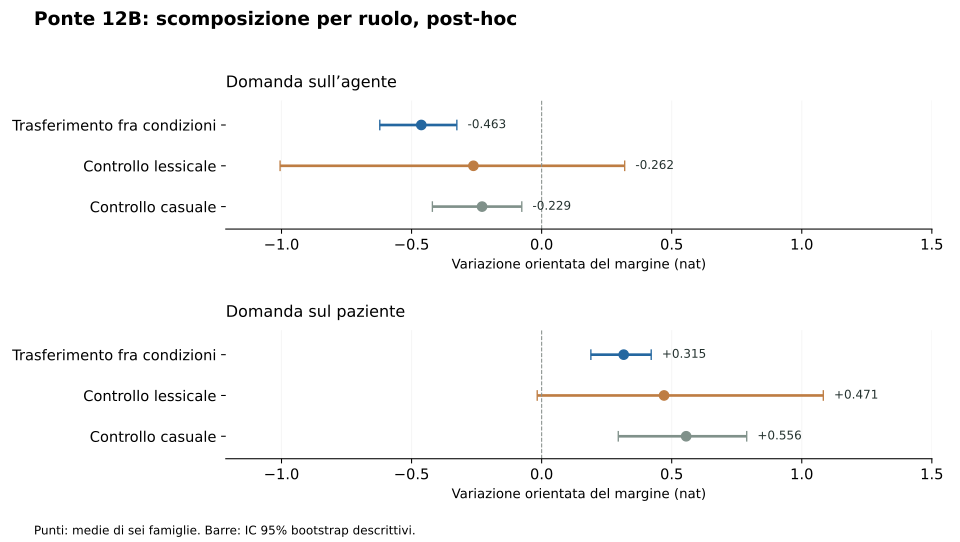
La scomposizione per domanda, effettuata dopo l’analisi aggregata, trova −0,463 [−0,622; −0,326] nats per l’agente e +0,315 [0,189; 0,421] per il paziente. Nelle passive del ponte il primo partecipante della principale è il paziente. Una spinta verso quel partecipante può quindi migliorare il margine della domanda paziente e peggiorare quello della domanda agente senza scambiare coerentemente due ruoli. Questa è una spiegazione compatibile con i dati, non un meccanismo già identificato. (Scomposizione esplorativa)
Una rianalisi successiva degli stessi dati, conservata nella V4, calcola esplicitamente la componente comune verso il primo partecipante. Vale 0,389 per il cross, 0,366 per il controllo lessicale e 0,392 per il casuale. I vantaggi appaiati cross meno controllo sono 0,023 [−0,697; 0,586] e −0,003 [−0,234; 0,215]. Non emerge un vantaggio specifico della patch della virgola su questa componente; gli intervalli ampi non dimostrano equivalenza fra interventi. (Rianalisi del ponte)
Questa analisi qualifica la lettura del risultato precedente. Non è una nuova replica, non aumenta il numero delle famiglie e non diventa confermatoria perché è salvata in una cartella con un nuovo numero di versione. Mostra perché la piccola media QA non andava liquidata come rumore, ma neppure promossa a prova di un trasferimento selettivo del ruolo richiesto.
La V4 originale si arresta prima di una nuova prova causale
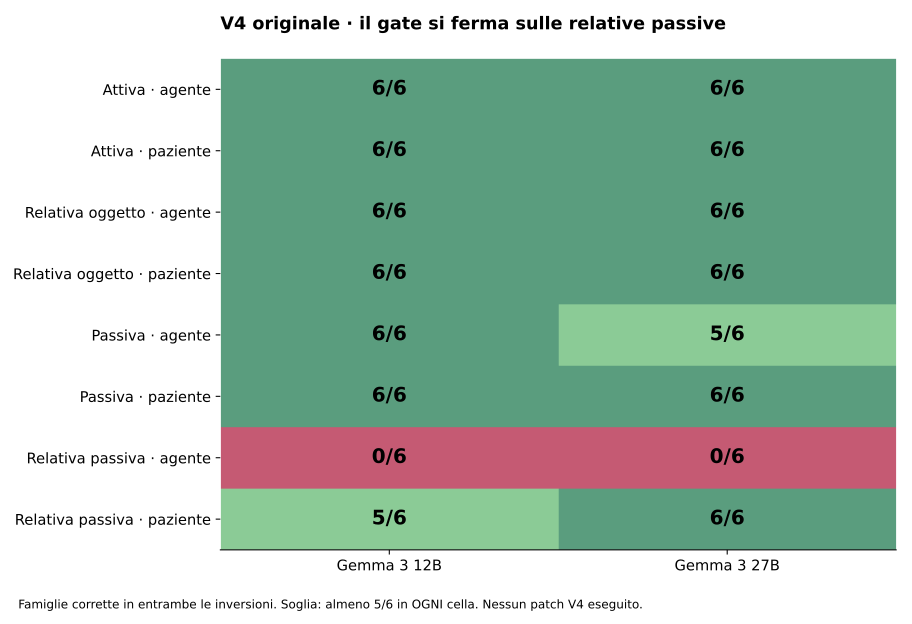
Per distinguere prima menzione, soggetto dell’evento e agente, la V4 originale introduce attive, passive, relative oggettive e relative passive dopo una subordinata del tipo «While the guard watched…». Nelle relative il primo partecipante resta però soggetto della principale finale: il disegno separa il soggetto del verbo interrogato dalla prima menzione, non ogni possibile nozione di soggetto grammaticale. (Protocollo V4)
La soglia richiede almeno cinque famiglie su sei, con entrambe le inversioni corrette, in ciascuna delle otto celle costruzione per domanda. Il 12B fallisce; il protocollo prevede allora il 27B, che fallisce a sua volta. La cella agente della relativa passiva ottiene zero famiglie su sei con entrambi i modelli. Per il 27B questo non significa zero risposte individuali corrette: l’accuratezza individuale è 25%, ma nessuna coppia completa supera il criterio. (Dati del gate)
Ciascun modello completa 96 osservazioni di sviluppo. Nessuna patch e nessuna osservazione di conferma vengono raccolte. Questo è l’ultimo tentativo ancora inserito nel disegno GPS qui considerato. Il limite raggiunto è operativo e scientifico: manca una misura comportamentale sufficientemente affidabile per interpretare l’intervento previsto. Non abbiamo un esperimento causale negativo sulla rianalisi; abbiamo un esperimento causale non avviato perché il prerequisito fallisce.
Livello 3 — Le quantità stimate, le verifiche e il prossimo test GPS
Le probabilità sono di token e stringhe, non di parse osservati
Per un token w e un prefisso x, la sorpresa è −log P(w | x). I logaritmi naturali producono nats. Nel confronto diagnostico V3 definiamo:
m(x) = log P(was | x) − log P(virgola | x)
È il logaritmo del rapporto fra due probabilità. Non è la probabilità che il modello abbia scelto un parse: mancano una definizione esaustiva delle alternative strutturali e un modello che colleghi tali alternative ai due token. Esistono continuazioni diverse da entrambe. Perfino un rapporto molto grande fra due candidati può convivere con una bassa probabilità assoluta di entrambi.
La scelta di due token singoli evita che la misura primaria sommi automaticamente più termini per una candidata. Non elimina ogni dipendenza dal tokenizzatore, dal contesto o dalle frequenze lessicali. Il protocollo verifica che le alternative corrispondano effettivamente a un solo token aggiunto al prefisso usato, invece di assumere che la stessa stringa abbia ovunque la stessa segmentazione. (Definizione V3)
Per una risposta di più token, lo score è invece:
L(a | x) = somma_t log P(a_t | x, a_1, ..., a_(t−1))
q(x) = L(risposta corretta | x) − L(risposta errata | x)
Il modello riceve la candidata token per token durante lo scoring. Un margine positivo indica che la stringa corretta supera l’altra fra quelle considerate. Non certifica che una generazione libera produrrebbe esattamente quella risposta, né rende il margine una misura universale di fiducia. La specificazione delle candidate, del punto finale e del prefisso di risposta fa parte dell’esperimento.
L’interazione fattoriale V3 ha un significato preciso
Siano o il contesto con verbo opzionalmente transitivo e i quello con verbo intransitivo nel senso previsto. Il contrasto comportamentale con allineamento posizionale è:
I_baseline = [m(o, comma) − m(o, gap)]
             − [m(i, comma) − m(i, gap)]
L’effetto della patch è costruito nello stesso spirito, sostituendo alle differenze naturali gli spostamenti causati dall’intervento. Il trasferimento comma→gap viene letto rispetto alla baseline gap; il trasferimento gap→comma ha segno invertito per orientare entrambi verso il contrasto comma meno gap. Poi si sottrae l’effetto intransitivo da quello opzionale e si aggregano materiali e direzioni entro famiglia. (Protocollo e orientamento)
Questa convenzione conta. Senza riallineare il segno, due interventi efficaci in direzioni opposte potrebbero cancellarsi nella media. Con il segno riallineato, un effetto positivo significa che la sostituzione trasporta una differenza coerente con il donatore lungo l’asse del contrasto. Non significa che ogni probabilità aumenti né che ogni risposta corretta migliori.
Nel contrasto allineato V3 le due direzioni danno 6,776 e 6,422 nats, entrambe positive. La scomposizione del margine mostra +4,291 sul logaritmo di probabilità di was e −2,308 su quello della virgola. Poiché il margine sottrae il secondo termine, entrambe le componenti contribuiscono all’aumento complessivo. Il risultato non deriva esclusivamente da una sola delle due alternative diagnostiche. (Scomposizione V3)
Il ponte 12B non è una replica quantitativa dello stesso estimando
Il ponte usa un semplice contrasto comma/gap in un contesto sintetico con principale passiva; non conserva la sottrazione del controllo intransitivo V3. Cambiano anche modello, precisione, materiali, prompt e sito in termini di profondità assoluta. Di conseguenza 6,599 e 8,069 non formano una curva di scaling. Sottrarli non misura quanto l’effetto cresca passando da 1B a 12B.
Il ponte misura due endpoint durante gli stessi forward, un vantaggio utile per collegare l’intervento alle uscite. Non rende però identici i problemi statistici. La previsione riguarda il prefisso prima di was, la QA il prompt completato con una domanda e le candidate. Le domande agente e paziente condividono la frase, ma hanno gold diversi. Una spinta generale verso un partecipante può assumere segni opposti nel margine corretto.
Anche nel ponte le direzioni vengono riallineate. Il cross clean→gap produce 8,126 sulla previsione e −0,100 sulla QA; gap→clean produce 8,011 e −0,047 dopo l’orientamento. L’intervallo QA della seconda direzione comprende zero, quello della prima no. L’aggregato è utile come riepilogo, ma non sostituisce questa struttura. (Direzioni del ponte, protocollo)
La posizione dello stato non coincide con il token previsto
Il sito patchato è l’ultimo token del secondo gruppo nominale, prima del disambiguatore. L’uscita in quella posizione contribuisce alla probabilità del token successivo. Confondere i due punti porta a scrivere che si interviene «su was», mentre si modifica uno stato che non ha ancora ricevuto was. Il controllo è deliberato: permette di studiare le aspettative prima dell’evidenza nuova.
In un decoder autoregressivo causale, una posizione precedente non accede ai token futuri. Quando viene fornito was, il suo stato e quelli successivi possono leggere il prefisso e integrare la nuova informazione. Lo stato già associato a poet non viene riscritto retroattivamente durante quel forward. La rianalisi, se descritta in termini di una rappresentazione aggiornata, deve quindi essere cercata anche in posizioni che hanno accesso al disambiguatore.
Ne segue un limite del disegno attuale: una patch prima di was può influenzare l’elaborazione successiva, ma non isola il calcolo che incorpora was. Il seguito intatto può ricostruire informazioni utili o rendere irrilevante parte della perturbazione. Questo spiega perché un effetto predittivo grande e una scelta QA stabile siano compatibili, senza scegliere a posteriori una di queste possibilità come meccanismo provato.
Copiare il residuo mostra influenza condizionata, non un circuito minimo
L’operazione sostituisce un intero vettore nel flusso residuo all’uscita del blocco selezionato. Quel vettore contiene il risultato accumulato di trasformazioni precedenti. Un effetto dimostra che la sostituzione può modificare l’endpoint in quel contesto. Non stabilisce dove l’informazione sia nata, quale componente la codifichi o se la stessa informazione sia disponibile altrove.
Per questo un blocco efficace non va chiamato «il layer della sintassi». Nella V2 il 17 viene scelto massimizzando una misura sullo sviluppo, e la successiva analisi mostra una fascia ampia. Nella V3 viene mantenuto, non riscoperto. Nel ponte il 32 deriva da una regola di profondità relativa. Queste sono tre giustificazioni operative, nessuna delle quali dimostra un’omologia funzionale esclusiva.
Anche la direzione dell’intervento limita l’inferenza. Portare uno stato dalla condizione con indizio a quella senza indizio e rimuovere quello stato dalla condizione con indizio sono manipolazioni differenti. Ridondanza, interazioni e possibilità di recupero possono renderle asimmetriche. Il fatto di provarle entrambe migliora la descrizione, ma non converte la coppia in una prova completa di necessità e sufficienza di una rappresentazione astratta. La distinzione è discussa nella guida metodologica di Heimersheim e Nanda. (Heimersheim e Nanda, 2024)
I controlli cercano spiegazioni alternative concrete
La patch identità reinserisce lo stato della stessa condizione. Un effetto non trascurabile qui indicherebbe che capture e scoring non riproducono lo stesso calcolo o che la sostituzione è implementata male. Nei run V3 e bridge12 completati l’errore identità massimo registrato è zero. È una verifica necessaria del meccanismo sperimentale, non una verifica della teoria linguistica. (Audit numerici)
Il controllo lessicale modifica un attore mantenendo la condizione strutturale prevista, poi adatta la lunghezza del vettore di spostamento a quella del cross. Il controllo casuale usa direzioni gaussiane, anch’esse adattate alla norma dello spostamento cross. Tre direzioni casuali vengono aggregate entro famiglia. Questi controlli chiedono se basti perturbare il residuo di un’ampiezza analoga o trasferire un’altra differenza contestuale per ottenere lo stesso effetto.
Norme uguali non implicano contenuti comparabili. Una direzione casuale non è una lettura sintattica alternativa naturale, e tre estrazioni non rappresentano tutte le perturbazioni possibili. D’altra parte, non sarebbe corretto ignorare un vantaggio sui controlli perché essi non coprono ogni spiegazione: eliminano quelle specifiche alternative operative, che sono parte della domanda sperimentale.
La letteratura metodologica mostra che scelta della misura e costruzione della perturbazione possono cambiare i risultati di localizzazione ottenuti con activation patching. Il punto pertinente qui è esplicitare endpoint, donatori e riferimenti, non trasformare una singola procedura in un rilevatore universale di circuiti. (Zhang e Nanda, ICLR 2024)
La precisione numerica fa parte della definizione operativa
V3 usa google/gemma-3-1b-pt, revisione fcf18a2a879aab110ca39f8bffbccd5d49d8eb29, in BF16. Il ponte usa google/gemma-3-12b-pt, revisione 295efb63d01a7017928f273a94ebb86105c9526f, in FP32, con TF32 disabilitato e attenzione eager. Queste informazioni distinguono i checkpoint effettivamente misurati da un generico nome di famiglia. (Provenienza dei run)
Il matching della norma viene controllato dopo le conversioni numeriche. Nel run V3 lo scarto relativo massimo è 2,491% nel contrasto allineato e 6,958% nell’insieme dei contrasti. Nel ponte FP32 è circa 8,56×10⁻⁷. «Controlli della stessa norma» significa quindi norme approssimativamente abbinate e misurate, con precisioni differenti fra i run; non una promessa di uguaglianza matematica perfetta in BF16.
Un’altra verifica riguarda l’invarianza del prefisso rispetto alle risposte candidate future. La maschera causale impedisce che una risposta futura alteri teoricamente uno stato precedente, ma forward con forme diverse possono produrre differenze numeriche. Il primo tentativo V4 12B si arresta su un controllo di questo tipo. Il run completato usa padding mascherato a destra per pareggiare la forma dei forward, valuta soltanto token reali e mantiene la soglia numerica. L’incidente è conservato, non contato come replica aggiuntiva. (Amendamento V4)
Sei famiglie restano sei famiglie, anche con migliaia di interventi
V3 registra 288 baseline e 3.456 interventi; il ponte 192 baseline e 576 interventi. Questi conteggi descrivono la copertura delle condizioni, non la numerosità di un campione di frasi indipendenti. Una stessa famiglia genera varianti, direzioni, controlli e domande correlate. Considerarle indipendenti renderebbe artificialmente stretto l’intervallo. (Conteggi verificati)
L’analisi aggrega prima le osservazioni all’interno della famiglia, poi ricampiona le sei famiglie di test con bootstrap percentile: 10.000 ricampionamenti, seed zero, intervalli al 95%. Per un confronto cross meno controllo si calcola una differenza appaiata, mantenendo il legame fra misure della stessa famiglia. Non si sottraggono semplicemente gli estremi di due intervalli separati.
Con sei cluster, gli intervalli sono descrittivi e condizionati ai materiali studiati. Non includono l’incertezza dovuta alla scelta iniziale del compito, del modello, del blocco, delle formulazioni o delle trasformazioni dei materiali. Non c’è una correzione globale per tutte le ipotesi e le analisi esplorate nel progetto. Un intervallo lontano da zero merita attenzione nel disegno specificato; non autorizza una generalizzazione illimitata al linguaggio naturale.
Analogamente, zero inversioni su 48 patch non dimostra una probabilità nulla di inversione in una popolazione. Le misure condividono sei famiglie, due ordini, domande e direzioni. È la descrizione esatta di ciò che è accaduto in quel test. Per stimare robustamente frequenze generali servirebbero nuovi materiali e una dimensione campionaria pensata per quella domanda.
Un test storico non resta inesplorato dopo la prima analisi
Il protocollo distingue sviluppo e test, e la cronologia registrata permette di verificare che la selezione prevista o il gate precedano il test del run. Questo protegge da alcune scelte opportunistiche all’interno dell’esperimento. Non trasforma l’intero programma in una preregistrazione indipendente: le versioni successive nascono conoscendo quelle precedenti.
Dopo l’ispezione, un insieme di test diventa evidenza storica. Le scomposizioni per ruolo del ponte e la componente comune analizzata nella V4 sono post-hoc anche se numericamente ricalcolabili. Usare quegli stessi sei gruppi per scegliere una nuova domanda e poi chiamare il nuovo risultato «conferma» confonderebbe sviluppo e valutazione.
Anche la separazione lessicale ha un perimetro. V3 divide le famiglie del verbo opzionale, non ogni nome e ogni verbo di controllo. Il ponte divide dodici frame sintetici e riusa alcuni predicati principali fra split. Nessuno dei due disegni dimostra generalizzazione simultanea a ogni componente lessicale nuova. I materiali pubblicati V3 possono inoltre essere stati incontrati nel pretraining; documentare la fonte non dimostra assenza di contaminazione. (Protocolli V3 e bridge12)
La prossima misura deve riguardare l’aggancio iniziale
Un seguito coerente con la domanda originale dovrebbe distinguere tre momenti: il prefisso ambiguo, l’arrivo del disambiguatore e posizioni successive prefissate. Le misure predittive prima del disambiguatore restano utili, ma vanno affiancate a un esito che dipenda dalla relazione sintattica da rivedere. La QA sulla principale può restare come controllo, senza essere l’unico indicatore.
Nell’esempio della guardia, non sarebbe corretto chiedere «La guardia non guardava il poeta?» e assumere che la frase finale implichi la negazione. La frase non specifica l’oggetto di watched; questo non dimostra che il poeta non fosse osservato. Una domanda del genere confonderebbe mancata implicazione e implicazione del contrario. Il readout deve distinguere strutture o conseguenze linguisticamente sostenibili, non premiare un gold costruito su una negazione indebita.
Serve prima un insieme di frasi nuove, con controllo della naturalezza e delle letture delle versioni esatte. La provenienza da esempi noti non basta quando si cambiano parole, punteggiatura o seguito. Il test comportamentale deve dimostrare che la versione non ambigua è risolta, che il prefisso ambiguo genera il contrasto atteso e che la misura finale risponde alla distinzione pertinente. Se il readout fallisce, l’analisi causale deve fermarsi prima di cercare un blocco favorevole.
Superati questi prerequisiti, si possono confrontare interventi prima e dopo l’evidenza nuova, in entrambe le direzioni, con siti fissati sullo sviluppo e conferma su famiglie non osservate. Identità, controlli lessicali, perturbazioni di riferimento e allineamento documentato restano necessari. Il successo richiesto sarebbe il trasferimento selettivo di una conseguenza della reinterpretazione oltre quei controlli. È una proposta di ricerca, non un protocollo già eseguito e non una promessa di risultato positivo.
Il rapporto con la letteratura chiarisce la domanda, non convalida i nostri risultati
Hanna e Mueller studiano l’elaborazione incrementale di ambiguità temporanee attraverso interventi e analisi di feature in altri modelli, inclusi Pythia-70m e Gemma-2-2B. Il loro lavoro distingue indizi compatibili con diverse letture e mostra che le feature rilevanti per le continuazioni spiegano poco delle successive risposte a domande. «Poco» non significa un effetto esattamente nullo, né esclusione definitiva di meccanismi di rianalisi. È un precedente pertinente alla separazione fra previsione e comprensione misurata, ma non una conferma indipendente del nostro Gemma 3. (Hanna e Mueller, NAACL 2025)
I riferimenti metodologici di Zhang e Nanda e Heimersheim e Nanda aiutano invece a interpretare il patching: la conclusione dipende da metrica, intervento, controllo e direzione. Il contributo di questo progetto va valutato sui propri materiali e dati, senza importare dai lavori precedenti una dimostrazione che i suoi esperimenti non hanno eseguito.
Verificare i risultati significa distinguere audit e replica
Il pacchetto pubblico contiene i dati aggregati e la provenienza, il manifesto dei file e i protocolli V2, V3, bridge12 e V4 originale. I sei grafici sono derivati dalle quantità registrate, con intervalli, denominatori e analisi post-hoc esplicitati. I due report dedicati, V3 su 1B e ponte su 12B, conservano letture separate degli esperimenti.
Per questo aggiornamento gli audit V3 e bridge12 sono stati ricalcolati dai record salvati, ottenendo oggetti uguali agli audit archiviati. È una verifica della coerenza fra dati grezzi e analisi, non una nuova replica GPU. Una replica richiederebbe rieseguire i checkpoint nelle condizioni documentate e confrontare i nuovi risultati. Anche un audit perfettamente riproducibile non certifica naturalezza degli stimoli, assenza di scorciatoie o validità della teoria proposta.
Lo stato scientifico raggiunto rende il prossimo passo più preciso: cercare il calcolo che incorpora la disambiguazione, con una conseguenza osservabile dell’aggancio da rivedere. Il risultato predittivo fornisce un punto di partenza causale e controllato. La distanza dalla reinterpretazione finale definisce ciò che manca ancora, e permette di progettare un test che possa davvero colmarla oppure mostrarne il limite.