Scheda del run del 9 ottobre 2026, conservata come resoconto sperimentale. Il report GPS aggiornato distingue effetti predittivi, risposte finali e rianalisi, e include le verifiche successive. Questi risultati non identificano da soli un meccanismo di reinterpretazione.
Aggiornamento interpretativo del 12 ottobre: nella scomposizione successiva, la componente comune verso il primo partecipante non mostra un vantaggio specifico sui controlli lessicale e casuale. Gli intervalli sono ampi; questo non dimostra equivalenza. I valori originali del run sono conservati.
V3 · Il ponte causale su Gemma 3 12B
Esperimento completato sul test tenuto da parte. Il modello ha superato il controllo di comprensione sia sulle frasi semplici sia su quelle con virgola dello sviluppo.
Il 12B era stato selezionato dopo il fallimento di 1B e 4B sulle stesse domande semplici. Qui fissiamo un secondo protocollo e chiediamo se modificare uno stato prima di was cambi sia la previsione immediata sia la risposta successiva su agente/paziente.
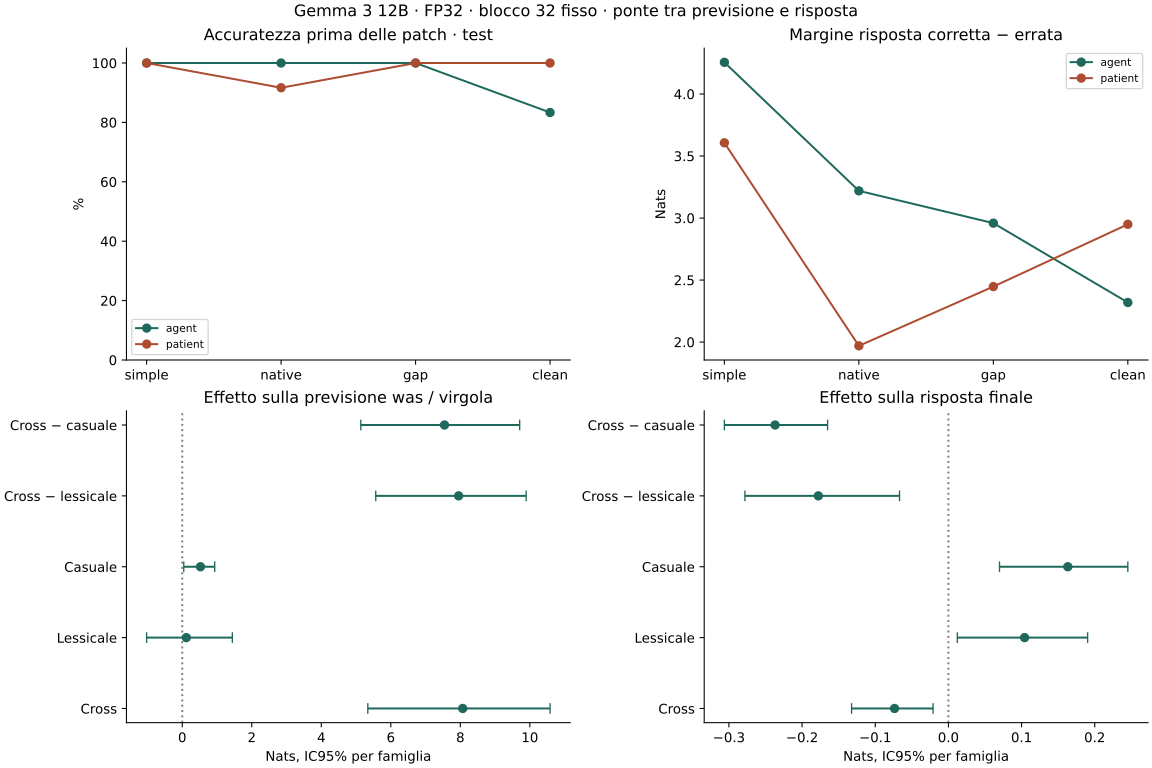
Sul test, l'effetto medio cross sulla previsione è 8.069 [5.338, 10.582] nats; sulla risposta finale è -0.074 [-0.132, -0.021] nats. Quest'ultimo non è un effetto nullo: aggrega spostamenti opposti per agente e paziente, senza cambiare il candidato scelto nei 48 interventi cross.
Comportamento prima delle patch
| Split | Condizione | Ruolo | Accuratezza | Entrambe le inversioni | Margine corretto [IC95%], nats |
|---|---|---|---|---|---|
| development | clean | agent | 91.7% | 83.3% | 2.837 [2.068, 3.470] |
| development | clean | patient | 100.0% | 100.0% | 2.585 [1.779, 3.238] |
| development | gap | agent | 100.0% | 100.0% | 3.413 [2.870, 3.929] |
| development | gap | patient | 91.7% | 83.3% | 2.185 [1.397, 2.777] |
| development | native | agent | 100.0% | 100.0% | 3.271 [2.781, 3.796] |
| development | native | patient | 91.7% | 83.3% | 1.751 [0.874, 2.461] |
| development | simple | agent | 100.0% | 100.0% | 4.127 [3.718, 4.473] |
| development | simple | patient | 100.0% | 100.0% | 3.638 [3.261, 4.014] |
| test | clean | agent | 83.3% | 83.3% | 2.319 [1.006, 3.392] |
| test | clean | patient | 100.0% | 100.0% | 2.950 [2.302, 3.684] |
| test | gap | agent | 100.0% | 100.0% | 2.959 [2.236, 3.752] |
| test | gap | patient | 100.0% | 100.0% | 2.448 [1.671, 3.179] |
| test | native | agent | 100.0% | 100.0% | 3.219 [2.678, 3.798] |
| test | native | patient | 91.7% | 83.3% | 1.970 [0.940, 2.909] |
| test | simple | agent | 100.0% | 100.0% | 4.255 [3.938, 4.542] |
| test | simple | patient | 100.0% | 100.0% | 3.607 [3.372, 3.883] |
simple: sola principale; native: subordinata senza virgola; gap: stessi token senza virgola, con ID posizionali allineati; clean: virgola prima del secondo nome. Frasi passive, due inversioni dei partecipanti, due domande per frase. La misura classifica due risposte complete, non generazioni libere.
Preferenza prima della disambiguazione
| Split | Condizione | Log P(was) − log P(virgola), media [IC95%] |
|---|---|---|
| development | native | -5.969 [-7.980, -3.809] |
| development | gap | -4.926 [-6.955, -2.852] |
| development | clean | 3.771 [3.382, 4.110] |
| test | native | -5.517 [-7.750, -3.077] |
| test | gap | -4.298 [-6.617, -1.786] |
| test | clean | 3.660 [3.334, 3.986] |
Questa preferenza locale precede il verbo; l'accuratezza QA riportata nella tabella precedente riguarda la frase completata. Non sono due misure intercambiabili di comprensione.
Interventi sulle sei famiglie di test
| Endpoint | Intervento / confronto | Media [IC95%], nats |
|---|---|---|
| next_effect | cross | 8.069 [5.338, 10.582] |
| next_effect | identity | 0.000 [0.000, 0.000] |
| next_effect | lexical | 0.117 [-1.025, 1.441] |
| next_effect | random | 0.524 [0.044, 0.934] |
| next_effect | cross_minus_lexical | 7.952 [5.567, 9.895] |
| next_effect | cross_minus_random | 7.544 [5.137, 9.708] |
| qa_effect | cross | -0.074 [-0.132, -0.021] |
| qa_effect | identity | 0.000 [0.000, 0.000] |
| qa_effect | lexical | 0.104 [0.012, 0.190] |
| qa_effect | random | 0.163 [0.070, 0.245] |
| qa_effect | cross_minus_lexical | -0.178 [-0.278, -0.067] |
| qa_effect | cross_minus_random | -0.237 [-0.306, -0.165] |
Effetti orientati come clean − gap: la direzione inversa è negata. Positivo indica un aumento dell’endpoint nel trasferimento verso lo stato con virgola; non implica automaticamente un miglioramento della comprensione. next_effect è log P(was) − log P(virgola); qa_effect è il margine risposta corretta − errata. Ogni effetto deriva dagli stessi forward pass.
Le due direzioni, senza nascondere asimmetrie
| Direzione (segno allineato) | Previsione: cross | Risposta: cross |
|---|---|---|
| clean_to_gap | 8.126 [5.326, 10.697] | -0.100 [-0.145, -0.052] |
| gap_to_clean | 8.011 [5.350, 10.467] | -0.047 [-0.117, 0.019] |
I tre seed casuali sono mediati prima delle coppie; ruoli, inversioni e direzioni prima delle famiglie. Intervalli bootstrap descrittivi: 10.000 ricampionamenti di sei famiglie. Non trattiamo tutte le patch come repliche indipendenti. Valori per famiglia, singole direzioni e sviluppo sono in audit.json.
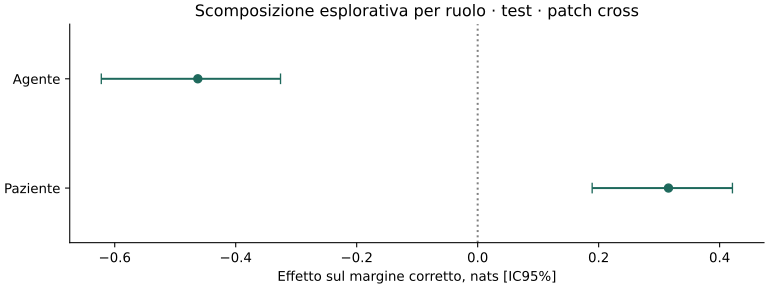
Diagnosi esplorativa: la media nasconde due effetti opposti
| Ruolo | Effetto cross sulla risposta [IC95%] | Cross − lessicale | Cross − casuale |
|---|---|---|---|
| agent | -0.463 [-0.622, -0.326] | -0.200 [-0.848, 0.644] | -0.234 [-0.500, 0.040] |
| patient | 0.315 [0.189, 0.421] | -0.155 [-0.777, 0.342] | -0.240 [-0.449, -0.047] |
Scelte finali cambiate: 0/48 interventi cross sul test. Le probabilità relative cambiano anche quando il candidato preferito resta lo stesso. Questa scomposizione per ruolo è descrittiva e post-hoc; non sostituisce l'endpoint primario medio.
Il calo del margine per l'agente e l'aumento per il paziente sono compatibili con uno spostamento verso il soggetto grammaticale della passiva (il paziente), comune alle due domande. I controlli non consentono di attribuirlo a un trasferimento selettivo del ruolo richiesto. Servono interventi che distinguano preferenza per un partecipante e informazione sul ruolo, prima di parlare di un circuito della comprensione.
Che cosa questo esperimento può stabilire
La patch sostituisce il residuo completo dopo il blocco 32, sull’ultimo token del secondo nome. Il blocco è stato fissato per profondità relativa rispetto al 17 del modello 1B, senza cercare il migliore sul 12B. Questa scelta non implica omologia tra i due modelli. I controlli lessicale e casuale hanno la stessa norma della perturbazione cross; il controllo identità deve riprodurre i punteggi originali.
Un effetto sulla previsione non basta a dimostrare rianalisi o comprensione dei ruoli. Qui misuriamo anche uno spostamento dei margini QA, ma nessun cambio delle scelte finali; i controlli e gli effetti opposti per ruolo richiedono un’interpretazione più limitata di un trasferimento della comprensione. Un intervallo QA che include zero non prova assenza di un circuito: il layer può essere inadeguato, l’informazione ridondante o ricostruita dai token successivi.
Questa è una differenza del segnale della virgola, non l’interazione opzionale-meno-intransitivo di V3: qui manca il controllo intransitivo fattoriale. Materiali sintetici, senza validazione umana; predicati principali possono ricorrere tra split. Le nuove misure non vanno confrontate in ampiezza direttamente con V3 1B, che usa altri materiali e contesti.
Riproducibilità
192 baseline, 576 interventi; modello google/gemma-3-12b-pt, revisione 295efb63d01a7017928f273a94ebb86105c9526f, FP32, attenzione eager, TF32 disabilitato. GPU: NVIDIA A100-SXM4-80GB; funzione: 389.2 secondi; picco memoria: 45.8 GiB. Tempi escluso provisioning.
Audit superato: 18 sorgenti, gate ricalcolato, ordine sviluppo → gate → test, somme token e differenze grezze ricostruite, completezza dei controlli. Errore massimo identità: 0.0; errore relativo massimo delle norme: 8.559525273010848e-07.
Protocollo congelato. Dati nella stessa cartella: metadata.json, source.json, materials.json, observations.jsonl, results.json, audit.json.